Datenqualität
sichern
Verlässliche Daten als Grundlage für belastbare Entscheidungen
The Information Lab unterstützt Unternehmen dabei, Datenqualität strukturiert aufzubauen und dauerhaft abzusichern. Dazu gehören klare Qualitätsregeln, automatisierte Tests in Datenpipelines, nachvollziehbare Transformationen und Datenmodelle, die fachliche Anforderungen zuverlässig abbilden.
Daten, die verlässlich sind
Ein Dashboard kann nur so verlässlich sein wie die Datenbasis, auf der es aufbaut. Unterschiedliche Formate, fehlende Werte, uneinheitliche Definitionen oder fehlerhafte Transformationen entstehen oft lange vor der Visualisierung und können Kennzahlen unbemerkt verfälschen. Datenqualität sollte deshalb bereits bei der Integration, Transformation und Bereitstellung systematisch abgesichert werden.
The Information Lab implementiert automatisierte Qualitätsprüfungen direkt in ELT- und Datenpipeline-Prozessen. So lassen sich Auffälligkeiten, logische Fehler und Regelverletzungen erkennen, bevor sie in Reports oder Datenprodukte gelangen. Dabei arbeiten wir toolagnostisch und orientieren uns am bestehenden Tech Stack. Für skalierbare und nachvollziehbare Transformationen setzen wir häufig auf Frameworks wie dbt, wenn sie zur Architektur und zum Anwendungsfall passen.
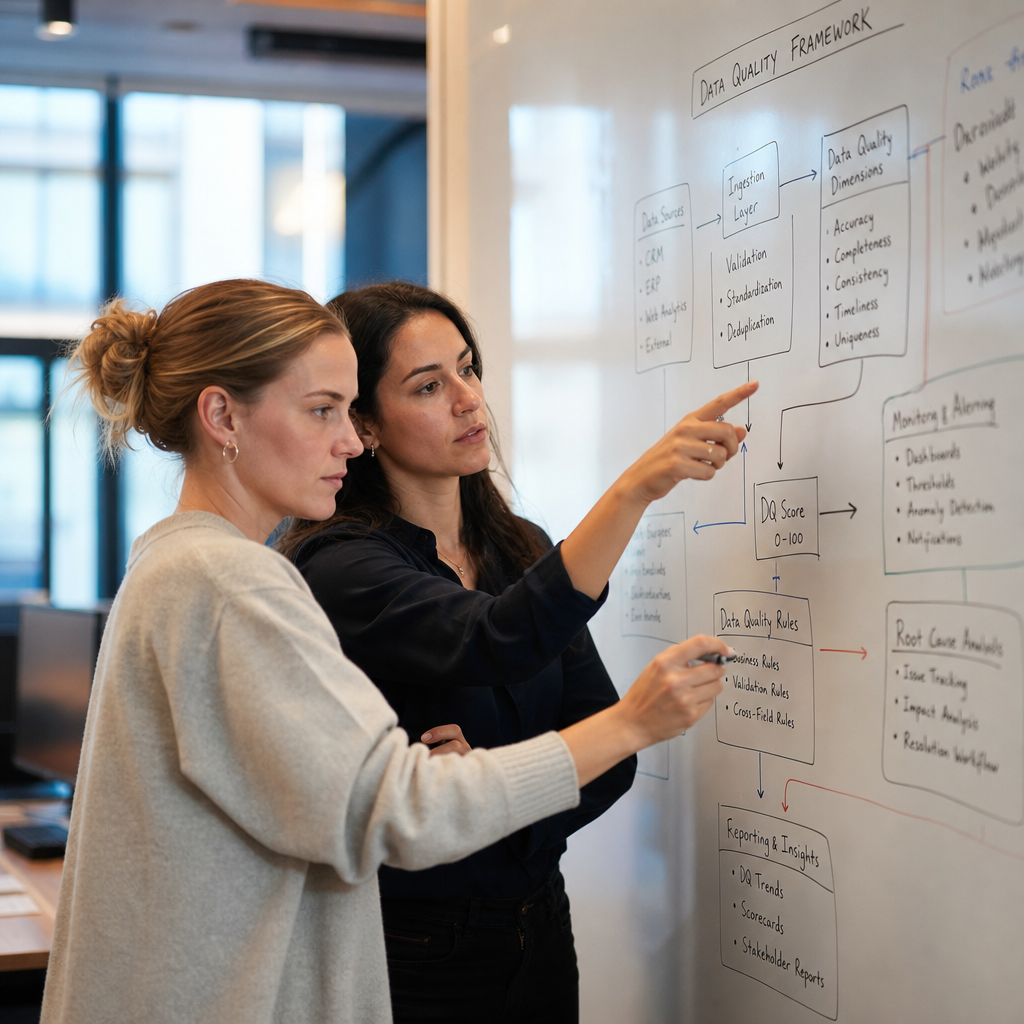
Datenqualität mit The Information Lab
The Information Lab verbindet Data Engineering mit einem tiefen Verständnis für BI, Analytics und fachliche Anforderungen. Dadurch betrachten wir Datenqualität neben der Technik auch aus der Perspektive der Menschen, die später mit den Daten arbeiten.
Viele Datenqualitätsinitiativen starten im Backend. Wir ergänzen diese Perspektive um die Frage, welche Datenmodelle, Kennzahlen und Strukturen für nutzbare Analysen wirklich benötigt werden. Erfahrung aus Dashboarding, Reporting und Visual Analytics fließt direkt in die Gestaltung von Datenmodellen, Tests und Qualitätsregeln ein.
Was gute Datenqualität leisten muss
Gute Datenqualität entsteht durch klare Regeln, stabile Datenmodelle, nachvollziehbare Transformationen und automatisierte Kontrollen direkt in den Datenprozessen. Einzelne Prüfungen am Ende der Datenstrecke reichen dafür nicht aus.
Auf diese Weise wird Qualität strukturiert in Pipelines, Modelle und Reporting-Grundlagen eingebaut und bleibt im laufenden Betrieb besser nachvollziehbar.
- Valide Datenmodelle
Datenmodelle bilden fachliche Logik korrekt ab und ermöglichen konsistente Kennzahlen. - Automatisierte Tests
Qualitätsprüfungen in Datenpipelines helfen dabei, Fehler frühzeitig zu erkennen und kontrolliert zu beheben. - Klare Qualitätsregeln
Definitionen, Grenzwerte, Pflichtfelder und fachliche Prüfungen schaffen ein gemeinsames Verständnis dafür, wann Daten als verlässlich gelten. - Vertrauen in Reporting und Analytics
Wenn Datenqualität strukturiert abgesichert ist, können Fachbereiche Dashboards und Analysen sicherer nutzen.
Beispiel aus der Praxis
In einem Projekt für ein Großunternehmen entwickelte The Information Lab eine Dashboard-Suite inklusive Data Engineering. Vorbehalte gegenüber neuen Reports entstanden, weil unklare Berechnungslogik in der Vergangenheit zu falschen Ergebnissen geführt hatte.
Ein Beispiel war die gemeinsame Aggregation von USD- und EUR-Werten ohne saubere Währungslogik. Gelöst wurde das durch fachliche Klärung und bessere Modellierung: Geldwerte werden seitdem mit Währungsspalte geführt, standardisiert in Euro umgerechnet und ausschließlich über die Euro-Spalte aggregiert.
In der ELT-Pipeline wird diese Konvention automatisiert geprüft, etwa ob zu jedem Betrag eine gültige Währung und ein Umrechnungskurs vorliegen. Damit wird vor allem verhindert, dass derselbe Fehler erneut auftritt oder sich auf weitere Modelle ausbreitet.
Die Dashboard-Suite erhielt dadurch eine verlässlichere Datenbasis und konnte mit mehr Vertrauen genutzt werden.
Unser Vorgehen

Ausgangslage prüfen
Zu Beginn werden bestehende Datenquellen, Pipelines, Transformationen, Datenmodelle und Reports analysiert. Dabei wird sichtbar, wo Qualitätsrisiken entstehen und welche Fehler besonders kritisch für Entscheidungen sind.
Qualitätsregeln definieren
Gemeinsam mit Fachbereichen, Data Teams und IT werden Regeln für Datenqualität festgelegt. Dazu gehören technische Prüfungen, fachliche Plausibilitäten, Kennzahlendefinitionen und Anforderungen an Vollständigkeit, Konsistenz und Aktualität.
Tests automatisieren
Die definierten Qualitätsregeln werden in Datenpipelines integriert. So lassen sich Fehler, Abweichungen und Regelverletzungen frühzeitig erkennen, dokumentieren und gezielt beheben.
Datenmodelle stabilisieren
Datenmodelle und Transformationen werden so weiterentwickelt, dass sie fachliche Anforderungen zuverlässig abbilden und langfristig wartbar bleiben.
Teams befähigen
Datenqualität bleibt nur stabil, wenn Teams verstehen, wie Regeln, Tests und Datenmodelle zusammenspielen. Deshalb unterstützen wir mit Dokumentation, Enablement und praxisnaher Begleitung.
Datenqualität für BI, Analytics und AI
Verlässliche Daten sind nicht nur für klassische Dashboards wichtig. Auch AI-nahe Anwendungsfälle, Prognosen, Automatisierungen und Self-Service Analytics brauchen eine kontrollierte Datenbasis.
Je komplexer Datenlandschaften werden, desto wichtiger sind klare Prüfregeln, semantische Strukturen und nachvollziehbare Datenflüsse. Datenqualität schafft damit die Grundlage für belastbare Analysen, vertrauenswürdige AI-Anwendungen und skalierbare Datenprodukte.
Projektbezogene Unterstützung
mit Managed Data Teams
Wenn interne Teams zusätzliche Kapazität oder spezialisiertes Know-how benötigen, unterstützen unsere Managed Data Teams gezielt bei der Umsetzung. Sie helfen dabei, Qualitätsregeln zu definieren, automatisierte Tests aufzubauen, Datenmodelle zu stabilisieren und bestehende Pipelines weiterzuentwickeln. Datenqualitätsinitiativen lassen sich projektbezogen voranbringen, ohne dass Verantwortung und Wissen außerhalb der Organisation verbleiben.
Vertrauen durch
Erfahrung und Sicherheit
Datenqualität ist eng mit Sicherheit, Nachvollziehbarkeit und professionellen Standards verbunden. The Information Lab ist ISO 27001 zertifiziert und arbeitet mit Unternehmen, bei denen Vertraulichkeit, Datenintegrität und belastbare Prozesse besonders wichtig sind.
Unsere Consultants bringen Erfahrung aus BI-, Analytics-, Data-Engineering- und Cloud-Projekten mit und arbeiten mit Technologien wie dbt, Snowflake, Tableau, Power BI und weiteren Lösungen. Gleichzeitig bleiben wir toolagnostisch und richten Qualitätssicherung an der bestehenden Architektur und den konkreten Anforderungen aus.
Externe Bewertungen auf ProvenExpert geben zusätzlich Einblick in die wahrgenommene Qualität unserer Zusammenarbeit. Über 900 Bewertungen und ein Schnitt von 4,8 von 5 Sternen bestätigen unsere Verlässlichkeit, Expertise und Praxisnähe.
Trainings & Webinare
Datenqualität bleibt nur stabil, wenn Teams verstehen, wie Qualitätsregeln, Datenmodelle und automatisierte Tests zusammenspielen. Unsere Trainings vermitteln praxisnah, wie Datenqualität entlang von Pipelines, Transformationen und BI-Anwendungen abgesichert werden kann.
Relevante Fachartikel
 AI in BI
Semantic Layer für AI-Agenten Praxistest
 Information Lab Blog
UX-Prinzipien für moderne Dashboards
 Business Intelligence
Composable Published Data Sources in Tableau
Der nächste Schritt zu verlässlicher Datenqualität
Datenqualität lässt sich gezielt verbessern, wenn klar ist, wo Fehler entstehen, welche Daten besonders kritisch sind und welche Prüfungen automatisiert werden können.
Ein erster Schritt ist ein Blick auf bestehende Datenpipelines, Datenmodelle und Reports. Daraus lässt sich ableiten, welche Qualitätsregeln priorisiert werden sollten und wie automatisierte Tests Vertrauen in BI und Analytics stärken können.
Benjamin Gretsch
Lead Data Engineer
Startseite- & Serviceskontakformular
„*“ zeigt erforderliche Felder an
Weitere Fragen & Antworten
Warum liefern moderne BI-Tools oft inkonsistente oder widersprüchliche Kennzahlen?
Analyseplattformen wie Tableau oder Power BI visualisieren exakt die Informationen, die sie aus dem Backend erhalten. Wenn Kennzahlen in Dashboards widersprüchlich sind, liegt das Problem fast immer in der vorgelagerten Datenaufbereitung. Fehlende Währungsumrechnungen, unklare Definitionen oder abweichende Formate in den Quellsystemen führen zu verfälschten Ergebnissen. Eine strukturierte Datenqualitätssicherung setzt genau hier an und behebt Fehler, bevor sie das Reporting erreichen.
Wie lassen sich Qualitätsprüfungen in Datenpipelines automatisieren?
Manuelle Datenkontrollen – beispielsweise über Excel-Exporte – sind zeitintensiv und fehleranfällig. The Information Lab verlagert die Qualitätssicherung direkt in den ELT-Prozess. Mithilfe von Frameworks wie dbt werden automatisierte Tests definiert, die bei jedem Datenlauf prüfen, ob Werte fehlen, logische Grenzen überschritten werden oder Formate abweichen. Fehlerhafte Datensätze werden so rechtzeitig isoliert, was die Verlässlichkeit des Data Warehouses (z. B. in Snowflake) massiv erhöht.
Welchen Vorteil bietet die Frontend-Perspektive bei der Datenqualität?
Viele reine IT-Dienstleister betrachten Datenqualität isoliert als technische Aufgabe des Backends. The Information Lab kommt aus der Business Intelligence und weiß exakt, wie Daten strukturiert sein müssen, damit Fachbereiche sie im Alltag performant und intuitiv nutzen können. Diese Erfahrung aus dem Dashboarding fließt direkt in die Gestaltung von Datenmodellen und Qualitätsregeln ein, sodass die technische Aufbereitung immer einem klaren geschäftlichen Nutzen dient.
Welche Rolle spielt die Datenqualität bei der Einführung von Künstlicher Intelligenz?
Für klassisches Reporting ist schlechte Datenqualität ärgerlich, für AI-Initiativen ist sie ein K.-o.-Kriterium. Machine-Learning-Modelle und GenAI-Anwendungen lernen aus den bereitgestellten Informationen. Fehlerhafte, unvollständige oder verzerrte Rohdaten führen unweigerlich zu falschen Prognosen oder sogenannten Halluzinationen. Eine validierte, nachvollziehbare Datenbasis ist die zwingende Grundvoraussetzung, um Künstliche Intelligenz sicher und wertstiftend im Unternehmen einzusetzen.
Wie wird die Datensicherheit bei Qualitätsinitiativen garantiert?
Die Überprüfung und Bereinigung von Daten erfordert tiefen Einblick in geschäftskritische Prozesse. Als ISO 27001 zertifizierter Partner garantiert The Information Lab höchste Standards bei der Informationssicherheit. Vom Unternehmenssitz in Hamburg aus betreuen die Consultants Organisationen im gesamten DACH-Raum – darunter Konzerne und Unternehmen aus hochregulierten Branchen wie dem Finanz- und Gesundheitssektor, bei denen Vertraulichkeit und Datenintegrität oberste Priorität haben.