Wie wähle ich eine Data Engineering Plattform aus?

Welche Data Engineering Plattform passt zum Analytics-Setup?
Worauf es bei Warehouse, Pipelines und Toolstack ankommt
Die Wahl der richtigen Datenplattform gehört zu einer wichtigen Entscheidung, die ein Unternehmen im Bereich Analytics und Data Management trifft. Sie legt fest, wie flexibel Daten künftig verarbeitet werden können, wie hoch die laufenden Kosten ausfallen und wie schnell neue Anforderungen umgesetzt werden können. In diesem Beitrag zeigen wir, worauf es bei der Auswahl ankommt und werfen einen besonderen Fokus auf zwei zentrale Bausteine: Datenplattformen fürs Warehousing und skalierbare Data Pipelines.
Warum die Plattformwahl so wichtig ist
Eine Datenplattform ist das Fundament, auf dem Reporting, Analytics und auch AI-Anwendungen aufbauen. Dieser Beitrag fokussiert sich bewusst auf die integrierten Datenplattformen Snowflake, Databricks und Microsoft Fabric, die Storage, Compute und weite Teile des Toolstacks aus einer Hand anbieten. Ein alternativer Weg ist es, sich den Stack stattdessen selbst aus einzelnen Best-of-Breed-Komponenten zusammenzubauen, etwa einem Warehouse wie BigQuery oder Redshift, kombiniert mit separaten Tools für Orchestrierung, Transformation und BI. Dieser Modul-Ansatz ist nicht Gegenstand dieses Beitrags; hier geht es gezielt um die drei genannten Plattformen und darum, worauf es bei der Entscheidung zwischen ihnen ankommt.
„Die eine Plattform“ gibt es auch unter den drei Anbietern in der Praxis selten. Die meisten Lösungen bestehen aus einem Zusammenspiel mehrerer Tools, etwa einem Warehouse oder Lakehouse als Kern, ergänzt um Orchestrierungs-Tools, Transformationslayer und BI-Frontends. Eine falsche Entscheidung führt oft erst nach Monaten zu Problemen: steigende Kosten bei wachsendem Datenvolumen, Performance-Engpässe, oder Teams, die an Governance- und Sicherheitsanforderungen scheitern. Andererseits gilt auch: In einer gut durchdachten Infrastruktur funktioniert auch eine nicht ganz optimale Plattform exzellent.
Datenplattformen: Snowflake, Databricks und Microsoft Fabric im Vergleich
Bei der Auswahl einer Datenplattform dominieren aktuell drei Anbieter den Markt: Snowflake, Databricks und Microsoft Fabric. Alle drei verfolgen den Ansatz, Storage und Compute zu trennen, unterscheiden sich aber deutlich in Architektur, Zielgruppe und Ökosystem-Anbindung. Wichtig zu wissen, dass keine dieser Plattformen zwangsläufig alle Anforderungen allein abdecken. In der Praxis werden sie häufig mit weiteren Tools kombiniert, etwa dbt für Transformationen, Tableau oder Power BI fürs Reporting, oder Airflow für die Orchestrierung.
Architektur- und Philosophie-Unterschiede
- Snowflake ist ein klassisches Cloud Data Warehouse mit SQL-first-Ansatz. Die strikte Trennung von Storage und Compute über „Virtual Warehouses“ erlaubt feingranulare Skalierung, somit kann jedes Team oder jeder Workload sein eigenes Compute-Cluster erhalten, ohne sich gegenseitig zu blockieren. Snowflake hat sich in den letzten Jahren zunehmend in Richtung Data Lakehouse geöffnet (Iceberg Tables, Snowpark für Python), bleibt im Kern aber SQL-zentriert. Für Orchestrierung, Transformation und BI wird meist auf externe Tools wie dbt, Airflow, Tableau oder Power BI gesetzt.
- Databricks kommt aus der Spark-/Data-Science-Welt und positioniert sich als Lakehouse-Plattform: Daten liegen offen im Delta-Lake-Format, Compute erfolgt über Cluster, die sowohl für SQL-Analytics als auch für Machine Learning und komplexe Python/Scala-Workloads genutzt werden. Wer bereits stark in Richtung Data Science, MLOps oder Notebook-getriebene Entwicklung geht, findet hier die native Umgebung. Auch hier ist die Kombination mit dedizierten BI-Tools (Tableau, Power BI) und teils zusätzlichen Orchestrierungslösungen üblich.
- Microsoft Fabric bündelt mehrere frühere Microsoft-Produkte (Synapse, Power BI, Data Factory) in einer SaaS-Plattform mit einheitlichem Compute-Pool („Capacity Units“) und OneLake als zentralem Storage-Layer. Der große Vorteil liegt in der nahtlosen Integration von Lakehouse, Data Warehouse, Pipelines, Notebooks und Power BI in einer Oberfläche. Dabei merkt man Fabric seinen Ursprung deutlich an: Die Plattform ist historisch aus Power BI gewachsen, einem klassischen BI-Tool – und genau diese Nähe zahlt sich aus, wenn Data Analysts und Data Engineers eng zusammenarbeiten sollen, da beide Rollen sich in einer gemeinsamen Umgebung bewegen. Der Nachteil ist eine gewisse Unreife einzelner Komponenten und eine engere Bindung an das Microsoft-Ökosystem.
Praktische Entscheidungskriterien
| Kriterium | Snowflake | Databricks | Microsoft Fabric |
|---|---|---|---|
| Stärke | SQL-Analytics, Ease of Use, Konzepte wie Time Travel & Zero-Copy Cloning | Data Science, ML/AI, offenes Lakehouse-Format (Delta/Iceberg) | Integriertes Ökosystem inkl. Power BI, gute Wahl bei M365-Kontext, Gute Integration von BI und Data Engineering |
| Zielgruppe | BI- und Analytics-Teams, Data Engineers | Data Scientists, ML Engineers, Data Engineers | Unternehmen mit bestehender Microsoft-Landschaft, Analytics Engineers |
| Preismodell | Compute-Sekunden je Virtual Warehouse | Compute-Cluster (DBUs) + Cloud-Infrastrukturkosten | Capacity Units (gebündelt über alle Fabric-Workloads) |
| Offenheit des Datenformats | Zunehmend offen (Iceberg-Unterstützung) | Sehr offen (Delta Lake als Standard) | OneLake, Delta-kompatibel, aber stärker Microsoft-gebunden |
| Typischer Toolstack | Meist kombiniert mit dbt, Airflow, Tableau/Power BI | Meist kombiniert mit dbt/Workflows, Tableau/Power BI | Weitgehend nativ Pipelines, Notebooks, Power BI ist ein fester Bestandteil |
Worauf es bei der Entscheidung ankommt
- Workload-Profil: Überwiegend klassisches BI-Reporting spricht eher für Fabric oder Snowflake. Überwiegen ML- und Data-Science-Use-Cases, oder müssen sehr große Datenmengen bewegt werden, spielt Databricks seine Stärken aus.
- Bestehendes Ökosystem: Ist das Unternehmen stark in Microsoft 365/Azure verankert, senkt Fabric die Integrationshürden erheblich. Bei Multi-Cloud- oder Best-of-Breed-Strategien sind Snowflake und Databricks oft die neutralere Wahl.
- Team-Skillset: SQL-zentrierte Teams kommen mit Snowflake schneller voran. Teams mit Python/Spark-Erfahrung sind bei Databricks oder Fabric im Vorteil.
- Kostenmodell und Kontrolle: Snowflake und Databricks erlauben granulare Kostensteuerung pro Workload, Fabrics Capacity-Modell bündelt Kosten über alle Workloads hinweg – das kann Planungssicherheit geben, aber auch weniger Transparenz bei einzelnen Use Cases bedeuten.
- Bereitschaft zum Toolstack-Mix: Wer eine möglichst konsolidierte Lösung aus einer Hand sucht, ist bei Fabric am besten aufgehoben. Wer bewusst Best-of-Breed-Komponenten kombinieren möchte, findet bei Snowflake und Databricks mehr Freiheit, muss aber auch mehr Integrationsaufwand einplanen.
Ein Proof of Concept mit echten Datenmengen und typischen Abfragemustern bleibt in allen drei Fällen die verlässlichste Entscheidungsgrundlage. Benchmarks und Marketing-Vergleiche der Hersteller sollten nur als erste Orientierung dienen.
Skalierbare Data Pipelines
Data Pipelines sind das Rückgrat jeder Dateninfrastruktur. Sie transportieren, transformieren und laden Daten von der Quelle bis zum Verbraucher. Auch hier gilt: Der jeweilige Toolstack rund um Snowflake, Databricks und Fabric bringt unterschiedliche Pipeline-Bausteine mit, die bei der Bewertung berücksichtigt werden sollten.
- Elastizität: Kann die Pipeline mit wachsendem Datenvolumen automatisch skalieren, ohne dass Infrastruktur manuell angepasst werden muss? Cloud-native Lösungen bieten hier in der Regel klare Vorteile gegenüber On-Premise-Systemen. Alle drei der hier genannten Lösungen sind dafür gut geeignet.
- Orchestrierung im jeweiligen Stack: Bei Snowflake übernehmen meist externe Tools wie Airflow, dbt Cloud oder Orchestrierungsdienste der jeweiligen Cloud (z. B. Azure Data Factory) diese Aufgabe. Databricks bringt mit Workflows eine native Orchestrierung mit, wird aber ebenfalls häufig mit Airflow oder dbt kombiniert. Microsoft Fabric integriert Pipelines (auf Basis von Data Factory) direkt in die Plattform. Orchestrierung, Transformation und Storage liegen hier von Haus aus näher beieinander.
- Fehlerbehandlung & Monitoring: Snowflake und Databricks bieten solides natives Logging, verlassen sich bei komplexeren Alerting- und Monitoring-Anforderungen aber oft auf das jeweilige Orchestrierungstool (z. B. Airflow-Retries, dbt-Tests). Fabric bündelt Monitoring für Pipelines und Notebooks zwar in einer Oberfläche, wirkt hier aber – passend zum insgesamt jüngeren Reifegrad der Plattform – oft weniger ausgereift als die Monitoring-Optionen bei Snowflake oder Databricks.
- Kosten bei Skalierung: Snowflake und Databricks berechnen Pipeline-Läufe transparent nach Compute-Zeit des jeweiligen Warehouses bzw. Clusters, was eine feingranulare Kostenzuordnung pro Pipeline erlaubt. Bei Fabric fließen Pipeline-Läufe in die gebuchte Capacity Unit ein. Das vereinfacht die Kostenplanung, erschwert aber die Zuordnung einzelner Pipeline-Kosten. Erschwerend kommt hinzu, dass sich BI, ETL und Storage bei Fabric denselben Compute-Pool teilen, wodurch sich Lastspitzen gegenseitig beeinflussen können. Bei Snowflake und Databricks lassen sich Workloads durch separate Warehouses bzw. Cluster klarer isolieren.
Beispiel
Um das Ganze plastischer zu machen, schauen wir uns ein konkretes Projektbeispiel an: eine Plattformentscheidung, die wir bei The Information Lab von der Analyse der Ausgangslage bis zur Auswahl der passenden Lösung begleitet haben.
In dem hier beschriebenen Szenario handelt es sich um die DACH-Organisation eines globalen Konzerns. Auf globaler Ebene existierte eine Reihe von Datenbanken, vor allem Redshift und PostgreSQL in AWS. Ein Teil des Data Engineerings fand ebenfalls in AWS statt, vornehmlich über verschiedene AWS-Services wie Glue, Lambda, CloudFormation. Die Hauptprobleme dieses Setups: mangelnde Flexibilität und hohe laufende Kosten. Daneben war KNIME als Low-Code-ETL-Tool im Einsatz. Damit bauten vor allem Data Analyst:innen ohne tiefere Data-Engineering-Kenntnisse schnell eigene Datenpipelines, um Daten für Power-BI-Dashboards aufzubereiten. Dieser Ansatz stieß jedoch durch fehlende Skalierbarkeit, kein systematisches Testing und nur eingeschränkte Governance an Grenzen.
Gesucht war also eine Lösung, die beide Welten bedient: Data Engineers, die Code für komplexe Transformationen großer Datenmengen schreiben und Data Analyst:innen, die ohne tiefere Programmierkenntnisse die letzte Meile der Datentransformation bis zum Power-BI-Dashboard selbst gestalten können.
Dieser zweigleisige Ansatz mit High- und Low-Code für verschiedene Anwendergruppen, sowie das Frontend-Reporting, das bereits in Power BI lag, führten uns somit zu Microsoft Fabric.
In Fabric konnten wir über PySpark-Notebooks komplexe und effiziente Transformationslogiken etablieren und parallel über Dataflow Gen2, SQL-Skripte und Pipelines einen einfach zugänglichen Low-/No-Code-Weg anbieten. Da Power BI fester Bestandteil der Plattform ist, greifen Backend und Frontend nahtlos ineinander. Ein weiterer wichtiger Punkt hierbei: In vielen Unternehmen gibt es einen starken Disconnect zwischen Data Engineers und BI-Analyst:innen. Dadurch, dass auf derselben Plattform gearbeitet wird – wenn auch mit unterschiedlichen Tools –, wird die Kommunikation zwischen den Teams unterstützt. In diesem Fall war das umso relevanter, weil das Analyst:innen-Team vorrangig in Deutschland sitzt und Deutsch spricht, während das Data-Engineering-Team global verteilt ist und die Kommunikation also ohnehin komplexer war.
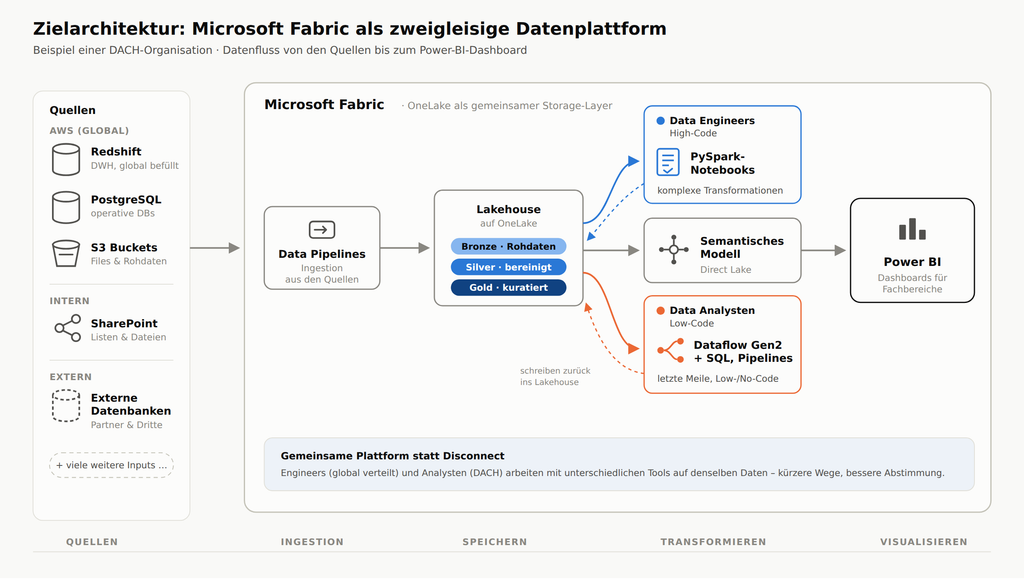
Ausschlaggebend für die Entscheidung waren hier also vor allem zwei der eingangs genannten Kriterien: das Workload-Profil und das Team-Skillset. Auf der einen Seite mussten Data Engineers weiterhin komplexe, codebasierte Transformationen für große Datenmengen umsetzen können, auf der anderen Seite brauchten Data Analyst:innen einen niedrigschwelligen Low-Code-Weg, um selbst die letzte Meile bis zum Power-BI-Dashboard zu gestalten. Dazu kam das bereits bestehende Ökosystem rund um Power BI als Reporting-Frontend, das den Umstieg auf Microsoft Fabric zusätzlich erleichterte. Dieses Zusammenspiel aus Workload-Anforderungen, Team-Skillset und vorhandenem Ökosystem gab letztlich den Ausschlag.
Fazit
Die Auswahl einer Datenplattform sollte nie allein anhand von Feature-Listen einzelner Anbieter erfolgen. Wichtig ist, wie gut Warehouse bzw. Lakehouse und Pipelines zusammenspielen, wie die Lösung mit dem Unternehmen mitwächst und wie gut sich der gewählte Toolstack in bestehende Prozesse integrieren lässt. Ein strukturierter Vergleich anhand konkreter Anwendungsfälle und ein Proof of Concept mit echten Daten liefern deutlich verlässlichere Ergebnisse als theoretische Bewertungen.
Ihr steht vor der Wahl der richtigen Datenplattform oder wollt Euren bestehenden Stack auf den Prüfstand stellen?
Als Beratungsunternehmen mit Projekterfahrung in Snowflake, Databricks, Microsoft Fabric sowie gängigen BI- und Orchestrierungs-Tools unterstützen wir Euch von der ersten Anforderungsanalyse über den Proof of Concept bis zur produktiven Umsetzung.
Gemeinsam entwickeln wir eine Architektur, die zu Euren Anforderungen, Eurer Systemlandschaft und Euren Zielen passt. Sprecht uns an, wenn Ihr Entscheidungen rund um Eure Datenplattform auf eine belastbare Grundlage stellen möchtet.
Dieser Artikel wurde mit Unterstützung von AI geschrieben und redaktionell geprüft.
Ähnliche Beiträge
 Data Engineering
dbt Snapshots: So historisierst du Slowly Changing Dimensions
 Information Lab Blog
Datenarchitektur: Warum flache Modelle die bessere Wahl sind
 Data Engineering
