AI Framework für Data Engineering: Medallion & Docs-as-Code

Auch wenn AI im Data Engineering inzwischen seit einigen Jahren eine zentrale Rolle spielt, sind Architekturkonzepte weiterhin recht rar. Viele Unternehmen arbeiten damit, Dateien hin und her zu kopieren, um sie einzeln zu verändern. Oder sie haben einfach AI-Tools und IDEs im Einsatz, ohne ein systematisches Konzept im Data-Engineering-Bereich einzusetzen.
Im Folgenden stellen wir ein AI-Konzept vor, welches wir in verschiedenen Kundenprojekten zur Anwendung bringen konnten und das viele Vorteile in der Arbeit mit AI aufweist, sodass die Entwicklungsgeschwindigkeit und auch -qualität deutlich verbessert werden können, wenn es konsequent umgesetzt wird.
Die Grundregeln
Fangen wir mit fünf einheitlichen Grundregeln an, welche zentral für das Konzept sind:

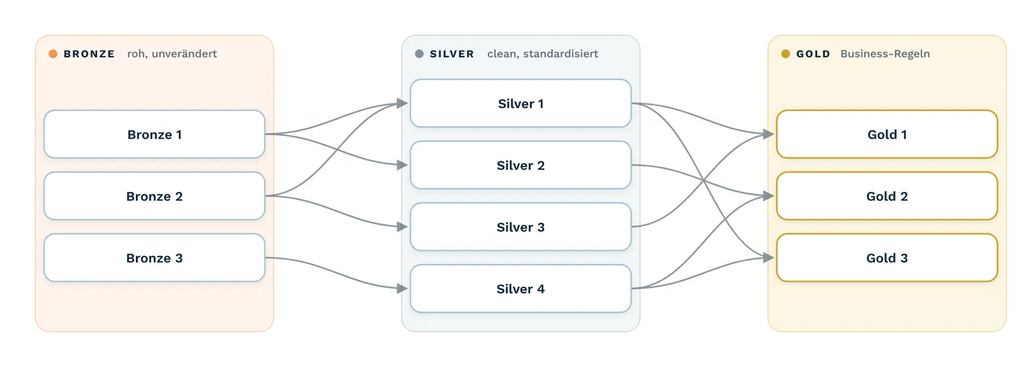
Medallion-Architektur
Data Engineering erfolgt IMMER nach Regeln der Medallion-Architektur.
🔹 Bronze · roh, unverändert
🔹 Silver · clean, standardisiert
🔹 Gold · Business-Regeln
Business-Logik liegt damit in der Datenbank, nicht im BI-Tool!
Eine Tabelle = Ein Notebook
🔹 Ein Notebook oder Skript schreibt immer genau eine Tabelle.
Doku steckt im Code
🔹 Doku direkt im Code pro Notebook, standardisiert als .md-Sektion.
🔹 Jegliche Doku wird in ein Dokumentationstool (z. B. Confluence) gesynct. Hier ist die Doku für jeden Konsumenten der Daten einsehbar.
🔹 Doku unterliegt CI/CD, so wie der Code auch.
Definition nach Use Case
🔹 Jeder Use Case hat eigene Gold-Tabellen sowie die zugehörigen Bronze- und Silber-Tabellen.
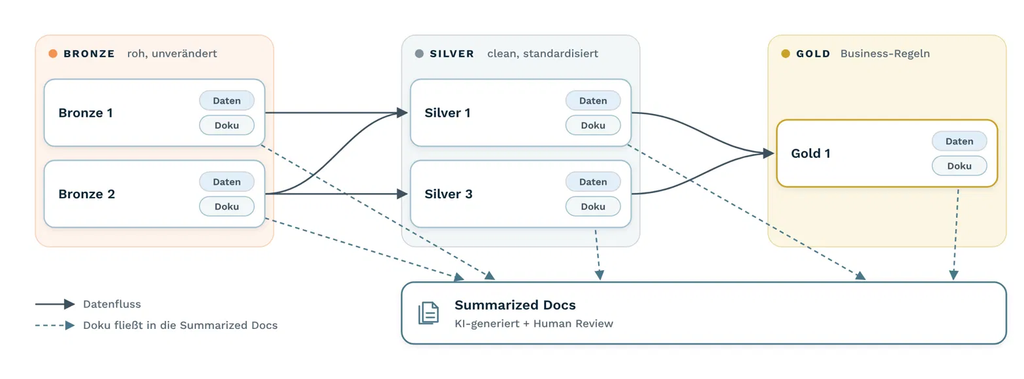
Jeder Use Case erhält eine zentrale Dokumentation.
🔹 Dazu eine Doku, die die drei Layer zusammenfasst.
🔹 Das heißt, die einzelnen Tabellen, welche zu einem Use Case gehören, fließen in ein einheitliches Dokument.
🔹 Zusätzlich kann diese Doku durch weiteren Content (allgemeine Regeln, PDFs, PPTs, …) angereichert werden. Diese Zusammenfassung kann maßgeblich durch AI generiert werden, sollte aber immer menschlich reviewt werden.
Ein Beispiel
Nehmen wir an, wir haben drei Gold-Tabellen, wobei jede einen eigenständigen Use Case abbildet.
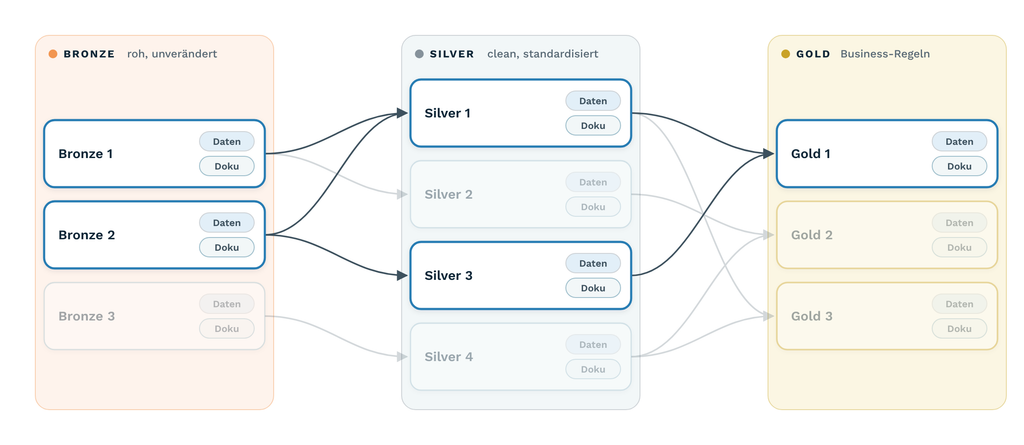
Jede dieser Tabellen beinhaltet beides: Daten und Dokumentation. Wenn wir jetzt einen Use Case isoliert betrachten, können wir die volle Data Lineage betrachten. In diesem Beispiel wird die Tabelle Gold 1 aus Silber 1 & 3 und diese wiederum aus Bronze 1 & 2 befüllt. Das heißt, über die 5 Tabellen und ihre Dokumentation erhalten wir ein vollständiges Bild darüber, was für Konsumenten vorliegt und woher diese befüllt werden beziehungsweise welche Transformationen erfolgen.
Wie werden Daten und Kontext genutzt?
Wir haben also eine Datenpipeline mit einer systematischen Dokumentation – nun stellt sich die Frage, wie das genutzt werden kann. Hier bieten sich grundsätzlich zwei verschiedene Ansätze an:
1. Toolspezifische AI-Funktionalitäten
Ganzheitliche moderne Datenplattformen wie Databricks, MS Fabric oder auch Snowflake bieten hier native Möglichkeiten. Alle Plattformen haben ihre eigene integrierte AI mit der Abfragen gegen die Daten sowie auch das Modifizieren von Pipelines, Architektur etc. möglich sind. Für all das bieten sich die nativen Funktionalitäten in der Plattform gut an, wenn auch mit unterschiedlicher Qualität bei verschiedenen Aufgaben.
Um den Kontext in die Plattform zu bekommen, lassen sich hier die APIs nutzen, über welche der Kontext systematisch befüllt wird. Über Funktionalitäten in Git-Tools wie etwa GitHub Actions lässt sich hier die Dokumentation automatisch an gewünschte Stellen syncen. Alternativ kann natürlich auch das hier beschriebene Konzept nativ in der Plattform integriert werden. Wie die Integration im Genauen aussieht, ist hier toolspezifisch, aber hier bieten alle modernen Datenplattformen Lösungen an, etwa Databricks Unity Catalog oder MS Fabrics Ontologie.
2. Toolagnostische AI
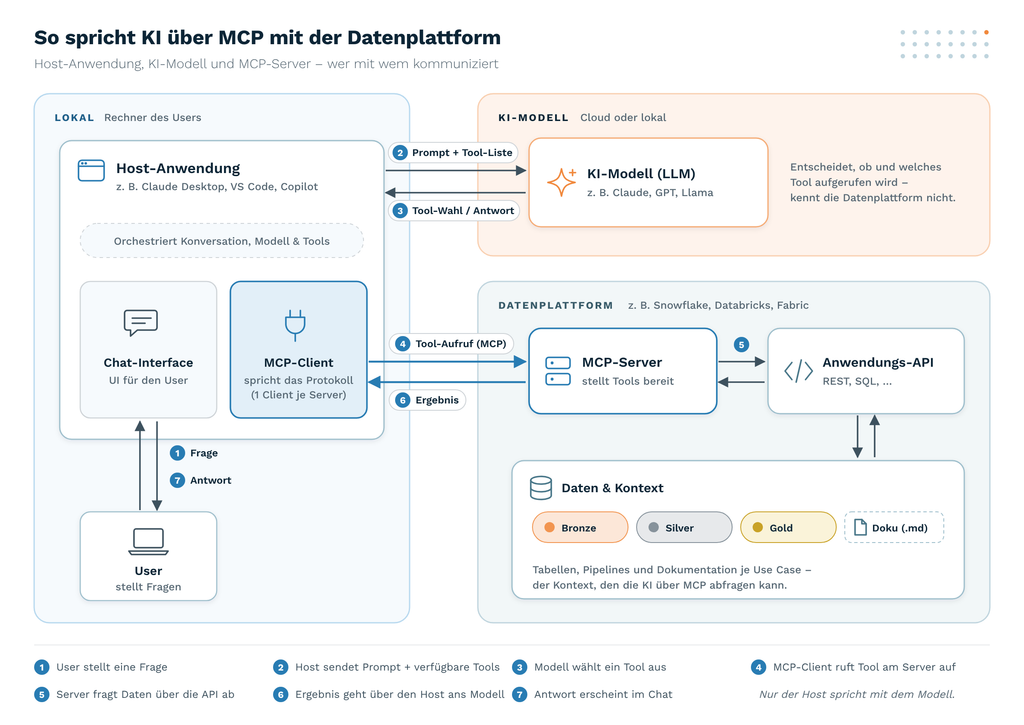
Die flexiblere – und unserer Erfahrung nach fast immer bessere – Variante bietet sich über eine toolagnostische AI-Konsumption. Über MCP (Model Context Protocol) lassen sich Datenbanken und Pipelines (wie etwa Snowflake) mit einem MCP-Client (etwa Claude, Copilot, …) verknüpfen. Dadurch kann über die APIs eine Kommunikation zwischen AI-Client und Datenplattform stattfinden.
Dadurch lässt sich die Plattform von der AI trennen, hier ist der Vendor-Lock-in also deutlich weniger stark. Außerdem kann auch eine Kommunikation über mehrere Tools hinweg kombiniert werden. Die Dokumentation kann somit beispielsweise in Notion (oder Confluence, SharePoint-Dateien, …) liegen und von der AI als Kontext für die Datenabfrage benutzt werden.
Wie die Kommunikation zwischen User, Host-Anwendung, AI-Modell und Datenplattform dabei im Detail abläuft, zeigt die folgende Grafik:
Das Ergebnis
Durch die Systematik in der Dokumentation ergibt sich ein einheitliches Bild für Nutzer:innen und auch für AI. Durch das klare 1:1:1-Mapping zwischen Transformationsprozessen (Code), Tabellen und Dokumentation ergibt sich nicht nur eine stringente Lineage (also eine volle Nachverfolgbarkeit der Datenbewegungen), sondern auch eine vollständige Kontextualisierung dieser.
Natürlich ergeben sich hier ähnliche Probleme wie schon immer bei Dokumentation. Dokumentation zu pflegen ist aufwendig und meist langweilig, weswegen Dokumentation in der Regel vernachlässigt wird. Die Lösung in diesem Framework ist daher:
- Dokumentation in den Code-Review-Prozess aufzunehmen (Git Reviews)
- AI möglichst viel selbstständig erfassen zu lassen, um den Anwender zu entlasten
- Dokumentation immer maximal codenah erfolgen zu lassen (Stichwort: Docs-as-Code).
Wie dieser Datenkontext bei der Arbeit mit AI genutzt werden kann, lässt sich wiederum auch in zwei Kategorien unterteilen:
1. Bauen & Pflegen mit AI
Durch die vollständige Kontextualisierung jeder Tabelle und jedes Notebooks (/Skripts) lässt sich über AI viel einfacher eine Pipeline neu aufbauen, und ganz besonders in der Bearbeitung bestehender Pipelines glänzt dieser Ansatz.
Dinge wie Logik verändern, Tests schreiben etc. können somit in den meisten Fällen vollständig über AI abgebildet werden und müssen anschließend nur menschlich validiert werden, anstatt von Grund auf erstellt zu werden.
2. Lesen mit AI
Durch die völlige Kontextualisierung ist auch der Leseprozess von Daten durch AI besser. Das Kontextmanagement ist in der Struktur der Plattform integriert. Hier können Endnutzer:innen der Daten direkt davon profitieren. Nutzer:innen können dann Abfragen im AI-Chatbot gegen die Daten schicken. Es werden dabei nicht nur die Daten, sondern auch deren Bedeutung, wichtige Anmerkungen, deren empfohlene Auslegung und vieles mehr direkt von der AI verarbeitet. Die Ergebnisqualität und auch die Geschwindigkeit der Abfrage sind somit deutlich verbessert.
Konkretes Beispiel – wie hilft der Kontext bei der Datenabfrage?
Nehmen wir das folgende Beispiel: Ein Setup, in dem wir Kontakteinwilligungen und CRM-Daten betrachten. Diese werden zusammengefügt, um eine einheitliche Kundenmastertabelle zu bekommen.
Wir haben also fünf Tabellen + Doku und zusätzlich die Summarized Docs.
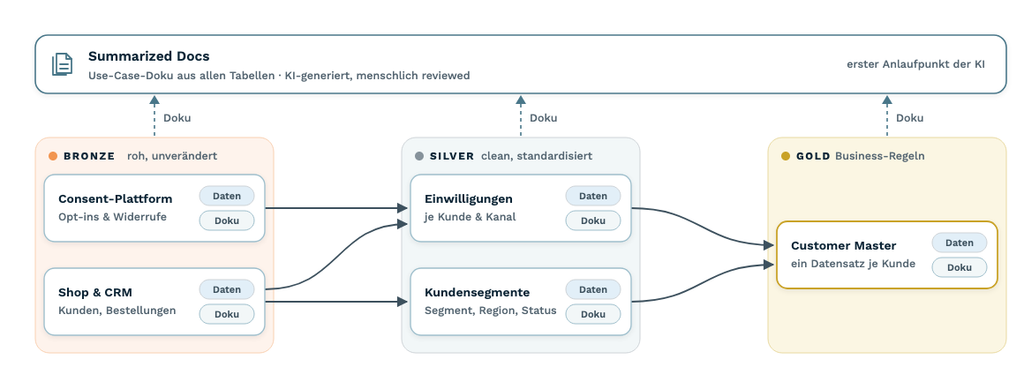
Betrachten wir drei Abfragen mit unterschiedlicher Detailtiefe:
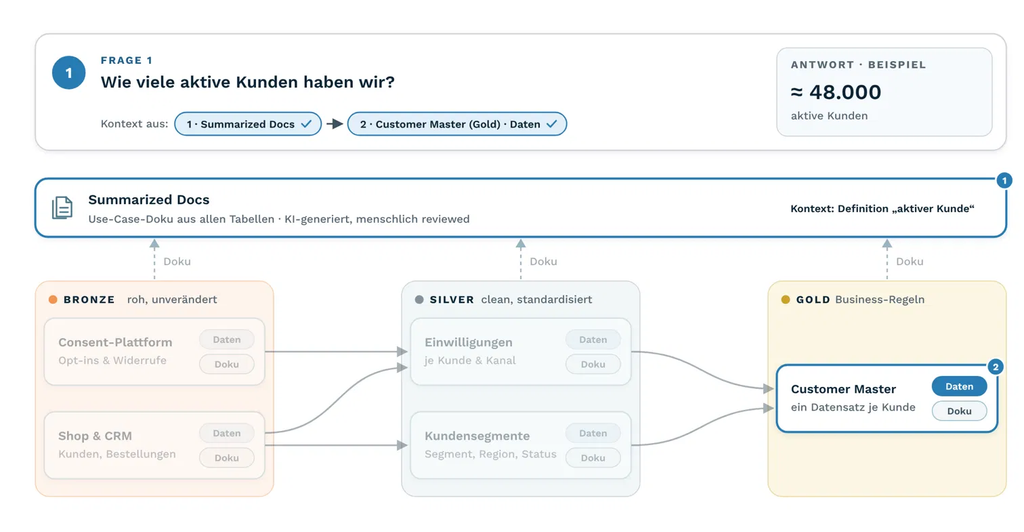
Frage 1: Wie viele aktive Kunden haben wir?
Diese Abfrage ist recht simpel: Die AI braucht nur herauszufinden, 1. wo die Kunden stehen und 2. was „aktiv“ bedeutet. Der Kontext dafür findet sich in den Summarized Docs. Daraufhin können die Daten der Gold-Tabelle abgefragt werden.
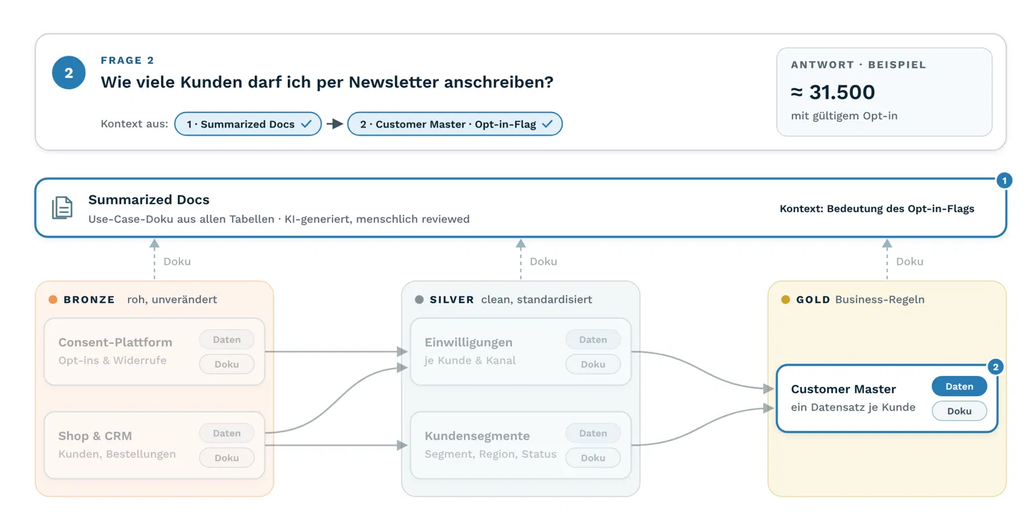
Frage 2: Wie viele Kunden darf ich mit einem Newsletter kontaktieren?
Diese Abfrage ist immer noch recht einfach, benötigt aber mehr Kontext, nämlich, was die Bedingung dafür ist, dass ich Kunden in diesem Format ansprechen darf. Hier handelt es sich vermutlich immer noch um eine Anfrage, die recht normal ist und damit auch in den Summarized Docs auftaucht. Die AI muss hier eine zusätzliche Filterbedingung zur vorherigen Frage hinzufügen und zieht diese Info aus der Doku.
Frage 3: Wie ist definiert, wen ich per Newsletter anschreiben darf?
Diese Frage geht auf die Grundlage der Daten ein – eine Definition, wie Daten entstehen, steckt in der Regel nicht in den Daten selbst. Somit ist die detailliertere Dokumentation hier essenziell. Wenn diese Information nicht in den Summarized Docs steckt ist weiteres Details, hier muss der AI Agent somit tiefer graben – in der detailierteren Einwilligungen-Silber Doku steckt dieses detail aber drin (oder alternativ im Code selbst). Damit lässt sich diese Info extrahieren.
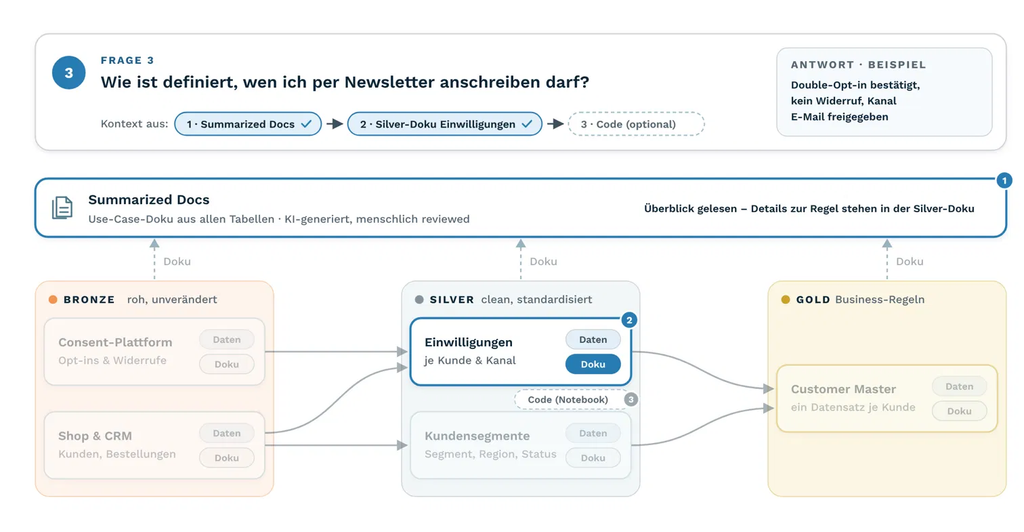
Eine kurze Anmerkung dazu: Die Summarized Docs enthalten nicht alle Infos der einzelnen Tabellen, da die meisten Details in Abfragen egal sind und daher nur zur Kontextverwirrung bei der AI führen würden. Trotzdem liest die AI die Summarized Docs immer zuerst: Sie liefern den Überblick und zeigen, in welcher Tabelle die Details stehen.
Zusammenfassung
Mit diesem Framework lässt sich also eine moderne Datenpipeline und -speicherung skalierbar und systematisch mit AI verknüpfen. Das Ergebnis ist, dass einige Aufgaben um ein Vielfaches schneller erledigt werden können. Nebenbei lässt sich auch durch AI die Implementierung der Regeln überprüfen und somit regelmäßig Prozesse updaten.
Hast Du Interesse daran, zu überprüfen, wie die Implementierung dieses Ansatzes in Deinem Unternehmen aussehen könnte? Dann melde Dich gerne, und wir sprechen gemeinsam über Möglichkeiten, dies umzusetzen.
Dieser Blogpost wurde persönlich geschrieben und mit AI überarbeitet. Bilder sind AI generiert.
