Semantic Layer für AI-Agenten Praxistest
Warum präzise Geschäftslogik entscheidend ist
Der Einsatz von Semantic Layer AI Agenten verändert die moderne Datenanalyse grundlegend, wirft aber auch zentrale Fragen zur Datenqualität auf. Wie stellt man sicher, dass ein AI-Agent tatsächlich verlässliche und exakte Antworten liefert – also die Art von verifizierten Daten, die man in offiziellen Geschäftsberichten benötigt?
Warum ein Semantic Layer für AI-Agenten die Basis bildet
In letzter Zeit haben wir durch die rasante Entwicklung der AI eine massive Verschiebung in der Welt der Datenanalyse erlebt. Konzepte wie „AI-Agenten“ und „Conversational Analytics“ dominieren jedes Branchengespräch und jede Konferenz. Dieser Wandel bringt jedoch auch große Kopfschmerzen mit sich: Wie stellt man sicher, dass der AI-Agent tatsächlich genaue Antworten liefert – also die Art von verifizierten, vertrauenswürdigen Daten, die man in offiziellen Geschäftsberichten sieht? Aus diesem Grund hat die Branche einen Schritt zurück gemacht, um sich auf eine entscheidende Voraussetzung zu konzentrieren: den Semantic Layer.
Ein Unternehmen aus dem Business-Analytics-Umfeld hatte das Potenzial dieses Wandels erkannt und entwickelte eine eigene AI-Agenten-Lösung für interne Analytics-Anwendungsfälle. Ad-hoc-Analysen spielen dort im täglichen Geschäft eine entscheidende Rolle: Neben traditionellen Dashboards benötigen die Fachbereiche schnelle und verlässliche Einblicke, ohne ständig auf Engpässe zu stoßen.
Die Vision war es, einen AI-Agenten zu bauen, der sich direkt mit den Datenquellen im Data Warehouse verbindet. Um diesen Agenten jedoch wirklich verlässlich zu machen, brauchten sie ein einheitliches Fundament: eine zentrale Schicht, in der Geschäftsdefinitionen, Berechnungen und Logiken einmalig definiert und universell angewendet werden.
Nach einer Analyse der aktuellen Semantic Layer Landschaft wurde ein eigenständiger Semantic Layer als vielversprechender Ansatz ausgewählt. Um diesen Ansatz auf die Probe zu stellen, hat The Information Lab gemeinsam mit dem Kundenteam einen praktischen Hackathon durchgeführt. Ziel war es, einen Proof of Concept zu entwickeln und zu prüfen, ob eine zentrale semantische Schicht die verlässliche Grundlage liefern kann, die für Ad-hoc-Analysen mit AI-Agenten erforderlich ist. Cube Core diente dabei als technische Engine für die Umsetzung.
Um die Ergebnisse des Hackathons einordnen zu können, hilft zunächst ein Blick darauf, welche Rolle ein Semantic Layer für AI-Agenten überhaupt spielt.
Was ist ein Semantic Layer?
Stellt Euch einen Semantic Layer als einen universellen Übersetzer zwischen Euren Datenbanken und den Menschen (oder AI-Agenten) vor, die diese Daten verstehen müssen.
In einem typischen Unternehmen werden Daten in Tabellen mit kryptischen Spaltennamen wie rev_mth_usd gespeichert. Ein Data Team kann einordnen, welche Spalten und Berechnungen für den „monatlichen Umsatz“ relevant sind. Aber ein AI-Agent oder ein BI-Tool (wie Tableau oder Power BI) könnte falsch raten, was zu halluzinierten Zahlen oder falschen Metriken führt.
Ein Semantic Layer liegt über Eurer Datenbank. Er definiert Eure gesamte Geschäftslogik, Definitionen und Beziehungen an einem zentralen Ort. Er sagt Euren Tools: „Wann immer jemand nach dem ‚Umsatz‘ fragt, berechne ihn genau so.“
Warum ist das für AI wichtig? Anstatt einen AI-Agenten zu zwingen, Euer gesamtes Datenbankschema spontan zu entschlüsseln, richtet Ihr die AI auf den Semantic Layer. Die AI liest die sauberen, menschenlesbaren Definitionen und generiert jedes Mal deutlich verlässlichere Abfragen.
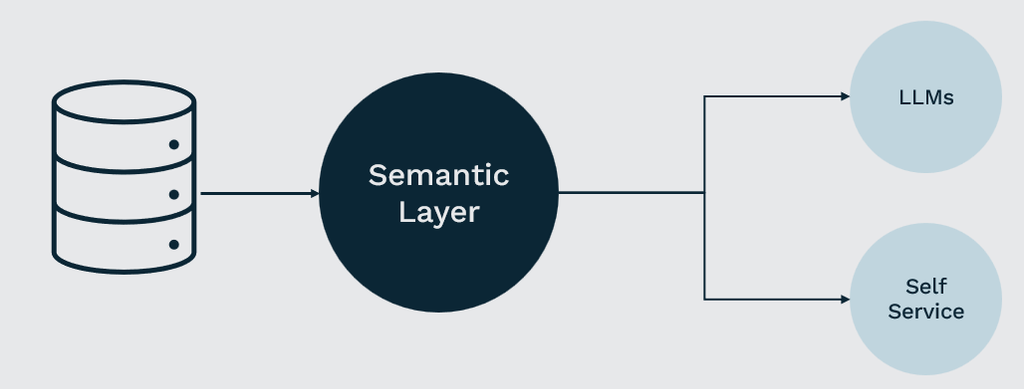
In Plattformen wie Tableau Next, Snowflake oder Databricks, in denen native AI-Agenten direkt in das Ökosystem integriert sind, können Nutzer:innen eingebettete semantische Modelle oder Ansichten einrichten. Diese ermöglichen es Teams, Aggregationen, Joins und spezifische geschäftliche Präferenzen vorab zu definieren. Wenn ein Unternehmen diese spezifischen monolithischen Plattformen jedoch nicht nutzt oder wenn seine Vision darin besteht, komplett eigene, maßgeschneiderte AI-Agenten von Grund auf zu entwickeln und zu hosten, muss es sich nach einem „Headless“- oder eigenständigen (Standalone) Semantic Layer umsehen. Diese unabhängige Schicht fungiert als einzige Quelle der Wahrheit („Single Source of Truth“) über jede Datenbank oder nachgelagerte AI-Anwendung hinweg. Für den Hackathon war genau dieser Punkt entscheidend. Getestet werden sollte, ob ein eigenständiger Semantic Layer als zentrale Übersetzungsschicht zwischen Data Warehouse, Geschäftslogik und AI-Agent funktionieren kann. Cube Core wurde dafür als Engine ausgewählt.
Die Rolle von Cube Core im Test
Um dieses Konzept in der Praxis zu testen, wurde Cube Core als quelloffenes Semantic-Layer-Framework ausgewählt. Es diente im Hackathon als rein technische Schnittstelle zwischen den Datenquellen und dem AI-Agenten.
Das Hackathon-Setup
Beim Übergang vom traditionellen BI-Reporting zu Agentic Analytics ist es ein kluger Ansatz, klein anzufangen, ein stabiles Fundament zu bauen und später zu skalieren. Unter Berücksichtigung dieser Philosophie wurde der Hackathon so konzipiert, dass er sich auf zwei stark genutzte, bereits existierende Geschäftsberichte konzentrierte, aufgeteilt auf zwei Teams. Durch die Verwendung etablierter Berichte stellten wir sicher, dass die Antworten der AI sofort verifiziert und die zugrunde liegende Logik leicht nachvollzogen werden konnte – was es uns ermöglichte, klar zu prüfen, was abstrakte Konzepte wie „Performance“ tatsächlich bedeuteten und wo spezifische Filter angewendet wurden.
Jedem Team wurde ein spezifisches Berichtsthema zugewiesen. Ihre Mission folgte einer klaren, dreistufigen Pipeline:

Datenbankverbindung herstellen
Eine direkte und sichere Verbindung zur zugrunde liegenden Datenbank aufbauen.
Semantische Modelle aufbauen
Robuste, strukturierte semantische Modelle inklusive Geschäftsregeln und Joins definieren.
AI-Agent anbinden & testen
Diese semantischen Schichten dem LLM zugänglich machen, um zu testen, wie genau der AI-Agent reale Geschäftsfragen beantworten kann.
Was ist also tatsächlich dabei herausgekommen?
Das Ergebnis war ein voller Erfolg: Durch die Nutzung einer zentralen semantischen Schicht war der AI-Agent am Ende des Tages in der Lage, präzisere und besser nachvollziehbare Antworten zu liefern.
Dies geschah jedoch nicht durch Zauberei gleich beim ersten Versuch. Es war das Ergebnis eines hochgradig kollaborativen, iterativen Engineering-Prozesses. Der eigentliche Durchbruch fand im kontinuierlichen Zyklus statt: den Agenten testen, überprüfen, wo er stolpert, und die semantischen Modelle durch Aktualisierung der YAML-Konfigurationsdateien von Cube gezielt härten. Jedes Mal, wenn eine Definition geklärt oder ein Join-Pfad im YAML-Code explizit zugeordnet wurde, wurde der AI-Agent verlässlicher und präziser.
Wenn man die Ansätze der beiden Teams kombiniert, sieht der Prozess, der zu einem guten Ergebnis führen soll, so aus:
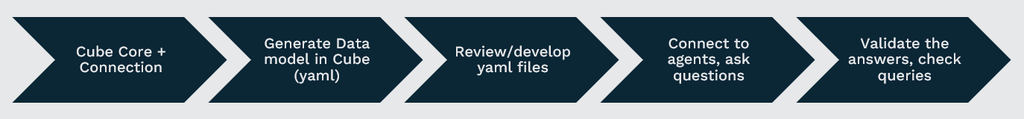
Semantic Layer + Verbindung
Zuerst richteten wir eine sichere Verbindung zwischen dem Semantic Layer und den zugrunde liegenden Data Warehouses ein.
Datenmodell generieren (YAML)
Wir generierten unsere Basis-Datenmodelle, indem wir die primären Tabellen und Schemata innerhalb der strukturierten Konfigurationsdateien definierten.
YAML-Dateien überprüfen / entwickeln
Hier fand die eigentliche Engineering-Arbeit statt. Wir verfeinerten die Datenmodelle, erstellten manuell komplexe Metriken, definierten strenge Tabellen-Joins vor und legten explizite Geschäftsregeln direkt im Code fest.
Mit Agenten verbinden & Fragen stellen
Wir machten unseren verfeinerten Semantic Layer für den LLM-gestützten AI-Agenten zugänglich und stellten ihm reale, mehrdeutige Geschäftsfragen, um seine Leistung zu testen.
Antworten validieren & Abfragen prüfen
Wir haben die Arbeit des Agenten auditiert. Indem wir die zugrunde liegenden SQL-Abfragen überprüften, die vom Semantic Layer generiert wurden, und die Ergebnisse mit unseren bestehenden, verifizierten Berichten abglichen, wussten wir sofort, ob die AI ins Schwarze traf oder eine Anpassung brauchte. Wenn sie stolperte, kehrten wir direkt zu Schritt 3 zurück, um die YAML-Dateien weiter zu härten.
Fazit und Zielbild
Der Tag war weit mehr als nur ein erfolgreiches Hackathon-Projekt. Er lieferte einen klaren Proof of Concept dafür, dass ein eigenständiger Semantic Layer eine tragfähige Grundlage für AI-Agenten in Business Analytics schaffen kann.
Der eigentliche Mehrwert dieses Zielbilds geht weit über ein einzelnes Chat-Interface hinaus. Indem der Semantic Layer ins Zentrum der Architektur gerückt wird, können AI-Agenten, Entwickler-Schnittstellen und traditionelle BI-Tools wie Tableau oder Power BI auf dieselben zentral gesteuerten semantischen Modelle zugreifen.
Die Erkenntnisse aus dem Hackathon bilden damit eine starke Grundlage, um AI-Agenten-Lösungen in zukünftigen Projekten weiterzuentwickeln, präziser zu machen und kontrolliert zu skalieren.
Wichtige Erkenntnisse aus dem Hackathon
Rückblickend auf unseren Tag sind hier die wichtigsten Lektionen für den Aufbau präziser, produktionsreifer AI-Analysen:
• Sofortiger Mehrwert
Eine semantische Schicht zwischen Datenbank und AI reduziert das Risiko, dass der Agent Daten frei interpretiert oder halluziniert.
• Kontext ist entscheidend
Die Bereitstellung expliziter Textdefinitionen für Begriffe wie „Performance“ gibt der AI genau die Leitplanken, die sie braucht, um die richtigen Daten zu finden.
• Sauberes YAML = Präzise AI
Behandelt Eure semantischen Konfigurationen wie Produktionscode. Wenn Ihr sie sauber und strukturiert hält, führt dies direkt zu präzisen AI-Antworten.
• Kontinuierlicher „Human-in-the-Loop“-Ansatz
Behebt Fehler nicht erst, nachdem sie aufgetreten sind. Bindet Datenexpert:innen bereits während der Entwicklung ein, um die Abfragen der AI zu überprüfen und die Modelle proaktiv zu härten.
Ähnliche Beiträge
 Information Lab Blog
UX-Prinzipien für moderne Dashboards
 AI in BI
AI und Dashboards im Zusammenspiel
 AI in BI
