Microsoft Fabric erklärt: Die 5 wichtigsten Komponenten für deinen Data Stack

Microsoft hat mit Fabric einen klaren Schritt weg von der fragmentierten Azure-Datenwelt gemacht. Statt dutzender Einzelservices bündelt die Plattform zentrale Funktionen für Datentransformation, Analyse und Visualisierung in einem integrierten Ökosystem.
MS Fabric ist also bereits deutlich reduzierter, hat aber immer noch viele verschiedene Services, welche für die meisten Unternehmen irrelevant sind. Im folgenden soll daher ein kurzer Überblick über die wichtigsten Komponenten in Fabric gegeben werden. Mit den hier beschriebenen fünf Services lässt sich hierbei eine vollständige Data Value Chain abbilden.
Warum immer mehr Unternehmen auf eine integrierte Plattform wie Fabric setzen und welche strategischen Trade-offs das mit sich bringt – erklären wir in unserem Artikel zum Microsoft Fabric Effekt.
Was ist Microsoft Fabric? Die Plattform in 60 Sekunden erklärt
Konzeptuell lässt sich MS Fabric in drei Schichten aufteilen:
- Das Lakehouse bildet das Datenfundament – hier landen alle Roh- und verarbeiteten Daten.
- Darüber liegt eine Transform-Schicht mit verschiedenen Tools für Code, SQL und visuelles ETL, orchestriert durch Pipelines.
- Am Ende steht Power BI als Visualisierungsschicht, die direkt auf das Lakehouse zugreift. Die Daten werden also in einer Plattform gespeichert, transformiert und visualisiert.
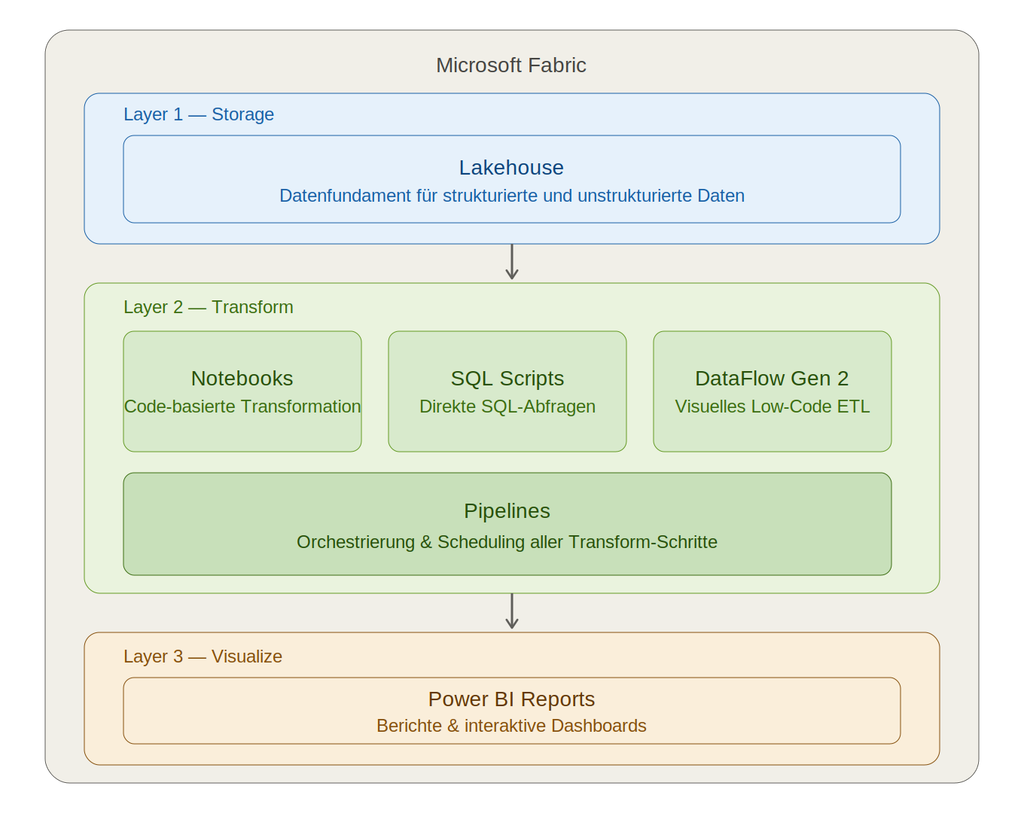
Darstellung: Verschiedenste Optionen der Datenspeicherung, – verarbeitung und visualisierung in MS Fabric.
Die 5 wichtigsten Microsoft Fabric Komponenten im Überblick
Lakehouse: Das Datenfundament von Microsoft Fabric
Das Fundament von Fabric. Das Fabric Lakehouse kombiniert klassischen File-Storage mit Tabellenspeicherung. Dies passiert auf Delta-Parquet-Format Basis. Das bedeutet, dass nur Änderungen gespeichert werden, inklusive vollständiger Historisierung.
Neben dem sehr performanten Tabellenspeicher gibt es noch weitere praktische Features in Fabric Lakehouses:
- Etwa das Shortcuts-Feature: Externe Tabellen aus anderen Systemen lassen sich direkt einbinden, ohne Daten zu duplizieren – dies ist jedoch nur für ausgewählte Datenbanken oder andere Fabric Lakehouses verfügbar.
- Zudem bietet das Lakehouse einen SQL-Endpoint, über den Analysten direkt mit SQL auf die Daten zugreifen können.
Notebooks: Code-basierte Transformation in Microsoft Fabric
Wer Code schreiben will, landet hier. Fabric Notebooks basieren auf Jupyter und unterstützen PySpark, Python, T-SQL, Scala und R. Warehouses lassen sich direkt über die UI verknüpfen. Der Überblick darüber, was existiert, bleibt erhalten.
Ein nützliches Feature: Notebooks können mit VS Code synchronisiert werden, was ein echtes Entwicklungsgefühl ermöglicht. Schwachpunkt bleibt die GitHub-Integration für CI/CD, die noch ausbaufähig ist.
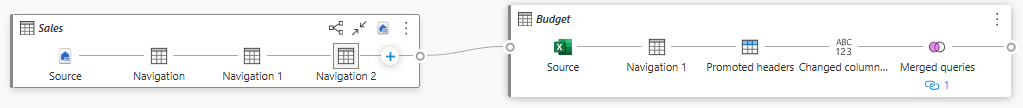
DataFlow Gen 2: Low-Code ETL für Power BI-Nutzer
Der visuelle Low-Code-ETL-Editor in Fabric. Im Vergleich zu dedizierten Low-Code Visual ETL Tools wie Alteryx oder KNIME ist der Umfang hier zwar etwas beschränkt, die wichtigsten Funktionalitäten für einfache Datenaufbereitung, wie Joins, Aggregationen, Filtern und einfache Transformationen, liegen aber vor.
DataFlow Gen 2 ist der direkte Nachfolger von Gen 1, das auf Power Query basiert – also exakt der Transformationssprache, die Power BI-Nutzer:innen bereits aus dem Query Editor kennen. Gen 2 baut darauf auf, bringt aber eine deutlich verbesserte Performance, eine überarbeitete Oberfläche und die direkte Anbindung an das Lakehouse mit.
Pipelines: Orchestrierung in Microsoft Fabric
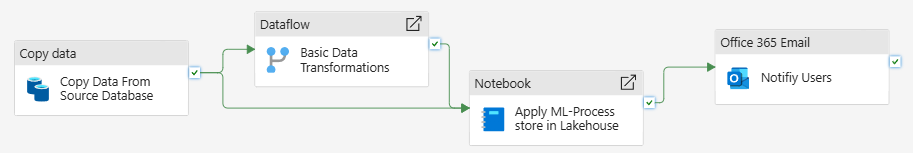
Pipelines koordinieren, was und wann verschiedene Services wie Notebooks oder DataFlows ausgeführt werden. Ähnlich wie Power Automate ermöglichen sie die Orchestrierung verschiedener Services in einer logischen Reihenfolge. Der Fokus liegt dabei auf Prozessorchestrierung und nicht auf Workflow-Automatisierung im klassischen Sinne.
Power BI in Fabric: Visualisierung direkt aus dem Lakehouse
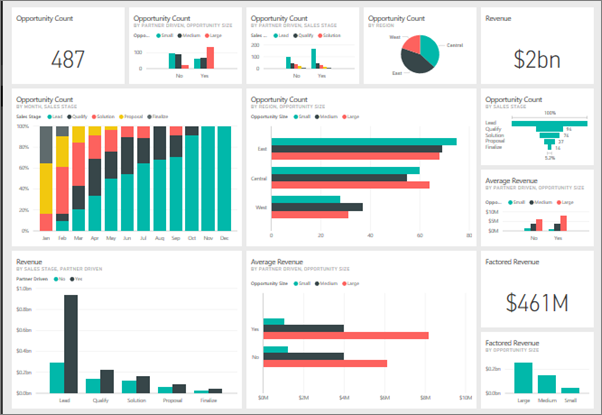
Power BI ermöglicht es, Daten zu visualisieren und in Berichte oder Dashboards zu überführen. In Fabric ist Power BI kein nachgelagerter Service, sondern ein zentraler Bestandteil der Plattform und das umfangreichste Tool im ganzen Ökosystem. Berichte lassen sich direkt an Lakehouses und Semantic Models anbinden.
Was Microsoft Fabric noch kann und was du eher meiden solltest
Fabric hat mehr zu bieten: Data Warehouse und SQL Database decken ähnliche Anwendungsfälle ab wie das Lakehouse, sind aber in gewissen Bereichen eingeschränkter, weswegen eine Nutzung selten einen Mehrwert über Lakehouses bringt. Darüber hinaus gibt es auch spezialisierte Tools wie Eventstreams und Activator für Echtzeit-Szenarien und einiges mehr, was aber in vielen Fällen mehr Verwirrung als Hilfe erzeugt.
Für die meisten Teams gilt: Weniger ist mehr. Wer sich auf Lakehouse + Notebooks + Pipelines + Power BI konzentriert, hat einen soliden, überschaubaren Stack – bevor man beginnt, die ganze Breite der Plattform auszureizen.
Fazit: Für wen lohnt sich Microsoft Fabric wirklich?
Lakehouse, Notebooks, SQL Scripts, DataFlow Gen 2, Pipelines und Power BI bilden den Kern von Fabric. Einzeln betrachtet ist keine davon die beste Lösung in ihrer Kategorie. Zusammen ergeben sie aber einen Stack, der durchgängig funktioniert: Daten landen im Lakehouse, werden transformiert und landen schließlich als Bericht in Power BI – alles in einer Plattform, ohne Datenverschiebung zwischen Tools.
Außerdem entwickelt Fabric sich zunehmend zur AI-nativen Plattform. Mit Copilot lassen sich Datenprozesse direkt aus der Plattform heraus steuern, Fabric IQ ermöglicht den Aufbau semantischer Modelle als Grundlage für AI-gestützte Datenabfragen, und via MCP lassen sich externe AI-Tools wie Claude oder Codex direkt anbinden.
Du planst den Aufbau eines modernen Data Engineering Stacks mit oder ohne Microsoft Fabric? Wir helfen dir beim Aufbau.
Was sind die wichtigsten Komponenten von Microsoft Fabric?
Die fünf wichtigsten Kernkomponenten für Deinen Data Stack in Fabric sind das Lakehouse (als Datenfundament für Roh- und verarbeitete Daten), Notebooks (für code-basierte Transformationen), DataFlow Gen 2 (als visuelles Low-Code-ETL-Tool), Pipelines (zur Orchestrierung der Prozesse) und Power BI (als zentrale Visualisierungsschicht). Wenn Du Dich auf diese konzentrierst, hast Du einen soliden und überschaubaren Stack, mit dem sich eine vollständige Data Value Chain abbilden lässt.
Wie funktioniert Microsoft Fabric und wofür brauche ich es?
Microsoft Fabric bündelt zentrale Funktionen für Datentransformation, Analyse und Visualisierung in einem einzigen, integrierten Ökosystem – und macht damit einen klaren Schritt weg von der bisher oft fragmentierten Azure-Datenwelt. Du brauchst es, wenn Du einen durchgängig funktionierenden Stack suchst: Deine Daten landen im Lakehouse, werden dort transformiert und fließen direkt als Bericht in Power BI. Alles passiert in einer Plattform, ohne dass Du Daten zwischen verschiedenen Tools hin- und herschieben musst.
Was ist der Unterschied zwischen Microsoft Fabric und Azure Data Factory?
Der Text geht zwar nicht explizit auf die Azure Data Factory ein, beschreibt aber den konzeptionellen Shift: Mit Fabric verlässt Microsoft die Welt der vielen Azure-Einzelservices und bietet ein integriertes Ökosystem. Für die Orchestrierung nutzt Du in Fabric die sogenannten Pipelines. Ähnlich wie Du es vielleicht aus anderen Orchestrierungs-Tools kennst, koordinieren diese Pipelines in einer logischen Reihenfolge, was und wann verschiedene Services (wie Notebooks oder DataFlows) ausgeführt werden.
Kann ich Microsoft Fabric ohne Power BI verwenden?
Theoretisch könntest Du die Daten- und Transformationsschichten (Lakehouse, Notebooks, Pipelines) nutzen, aber Power BI ist in Fabric bewusst kein nachgelagerter Service. Es ist ein zentraler Bestandteil der Plattform und das umfangreichste Tool im gesamten Ökosystem. Der wirkliche Mehrwert von Fabric entsteht genau durch dieses Zusammenspiel: Deine Berichte und Semantic Models in Power BI binden direkt an das Lakehouse an.
Ist Microsoft Fabric für kleine Unternehmen geeignet?
Ja, wenn Ihr Euch auf das Wesentliche fokussiert! Fabric bietet neben den Kernkomponenten zwar noch weitere Services (wie Eventstreams oder Activator), diese sind aber für die meisten Unternehmen irrelevant und erzeugen oft mehr Verwirrung als Hilfe. Für die meisten Teams gilt: Weniger ist mehr. Wenn Ihr Euch auf die Kombination aus Lakehouse, Notebooks, Pipelines und Power BI beschränkt, erhaltet Ihr auch als kleineres Team einen soliden, überschaubaren Stack, ohne Euch in der ganzen Breite der Plattform zu verlieren.
Ähnliche Beiträge
 Information Lab Blog
Tableau Writeback ohne Modellierungsaufwand: Infotopics Trulyp im Praxistest
 Information Lab Blog
SSRS-Migration mit AI: So bringt Ihr Eure Berichte nach Power BI und die Logik in die Datenplattform
 Information Lab Blog
