Data Pipelines: Extract und Load verstehen
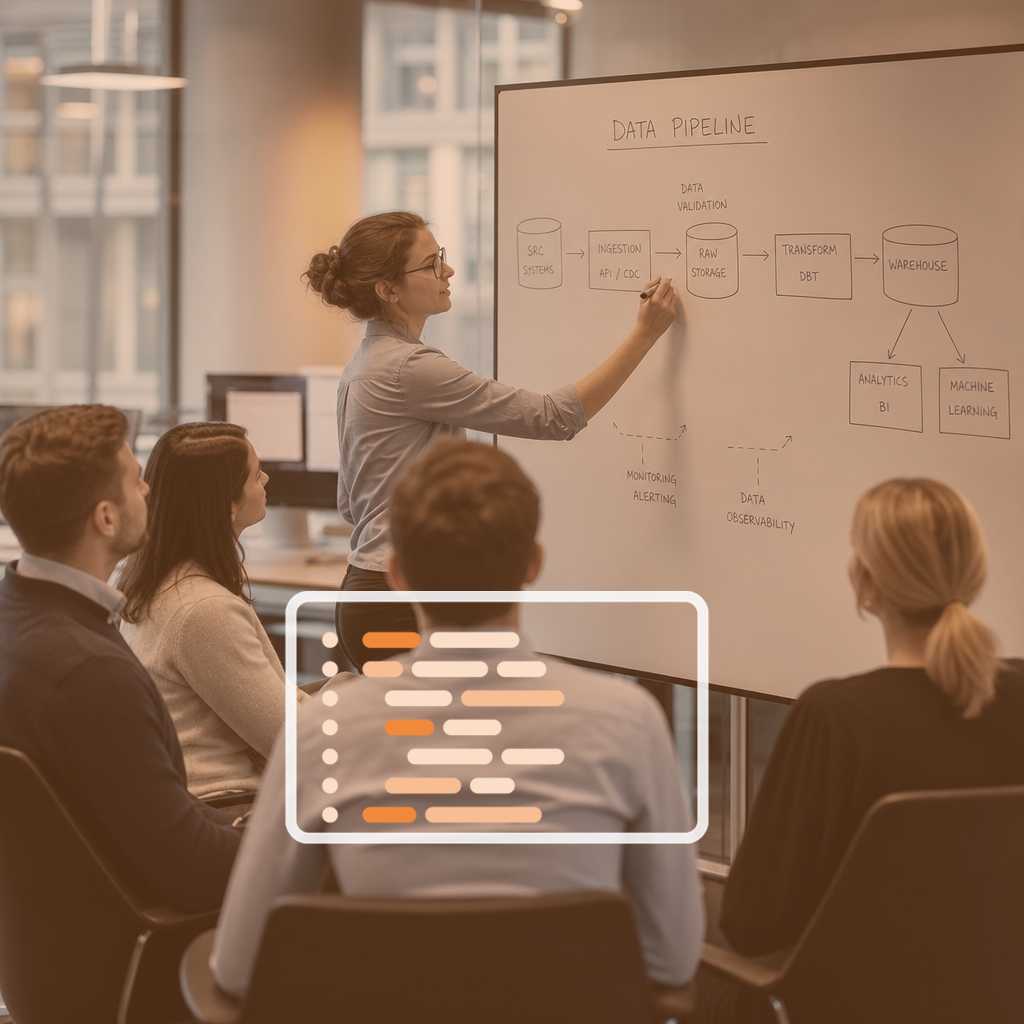
Bevor Daten analysiert werden können, müssen sie zuverlässig in das Data Warehouse gelangen. In diesem kostenfreien Webinar lernst Du verschiedene Ansätze für Extract und Load im modernen ELT-Stack kennen. Anhand konkreter Szenarien zeigen wir, wie sich Datenquellen anbinden lassen, welche Management-Optionen zur Verfügung stehen und welche Kriterien bei der Auswahl eines passenden Ansatzes eine Rolle spielen.
Worum geht es?
Im modernen ELT-Stack ist das „EL“ oft das unterschätzte Fundament: Ohne saubere, zuverlässige Datenpipelines kommt keine Transformation ans Ziel. Gleichzeitig gibt es heute mehr Optionen als je zuvor – von Fully Managed SaaS-Lösungen wie Fivetran über Self-Hosted Open-Source-Tools wie Airbyte bis zu nativen DWH-Integrationen wie Snowflake Snowpipe. Die Wahl hängt von Datenmengen, Latenzanforderungen, Infrastruktur und Budget ab.
Dieses Webinar schafft Orientierung: anhand von vier praxisnahen Szenarien wird gezeigt, welches Paradigma und welche Tools für welchen Fall geeignet sind und warum die Entscheidung zwischen Fully Managed, Self-Hosted und Eigenentwicklung mehr ist als eine Kostenfrage.
Das nimmst Du mit vom Data Pipelines Webinar
- Du lernst die Unterschiede zwischen Dateitransfers, API-Abfragen, Change Data Capture und event-basierten Pipelines kennen.
- Du erfährst, wie sich Fully Managed, Self-Hosted und Eigenentwicklungen unterscheiden und welche Anforderungen für die Auswahl relevant sind.
- Du beschäftigst Dich mit Themen wie Change Data Capture, Duplikaten, Datenqualitätsprüfungen, Rate Limits und API-Änderungen.
- Anhand konkreter Szenarien siehst Du unter anderem Fivetran, Airbyte, Azure Data Factory und Snowflake Openflow im jeweiligen Anwendungskontext.
- Du bekommst Kriterien an die Hand, mit denen Du unterschiedliche Ansätze für Deinen eigenen Data Stack besser vergleichen kannst.
Zielgruppe und Vorkenntnisse
Das Webinar richtet sich an Data Engineers, Analytics Engineers und Data Leads, die Datenpipelines planen, evaluieren oder verantworten.
Grundkenntnisse in Data Warehousing und ELT-Konzepten sind hilfreich. Tool-spezifische Vorkenntnisse sind nicht erforderlich.
Trainingsinhalte

Extract und Load im ELT-Stack
Einordnung der EL-Phase im modernen Data Stack und Abgrenzung zu klassischen ETL-Prozessen.
Management-Optionen für Datenpipelines
Fully Managed SaaS, Self-Hosted und Eigenentwicklung im Vergleich. Zusätzlich betrachten wir No-Code- und Code-First-Ansätze sowie Faktoren wie Kosten, Infrastruktur und Vendor Lock-in.
Szenario 1: Regelmäßige Dateianlieferung
Zeitgesteuerte und event-gesteuerte File Imports sowie Datenqualitätsprüfungen bei manuell gepflegten Daten. Beispiele sind Fivetran, Airbyte, Azure Data Factory und Snowflake Snowpipe.
Szenario 2: API-Abfragen in festen Intervallen
Anbindung regelmäßig aktualisierter Daten über APIs. Dabei betrachten wir unter anderem Rate Limits und API-Änderungen als relevante Faktoren. Beispiele sind Fivetran, Airbyte, Matillion und Adverity.
Szenario 3: Inkrementelle Updates aus operativen Systemen
Batching, Change Data Capture und der Transfer von OLTP- zu OLAP-Systemen. Wir schauen darauf, welche CDC-Methoden eingesetzt werden können und wie operative Systeme dabei berücksichtigt werden. Beispiele sind Airbyte, Fivetran, Azure Data Factory und Snowflake Openflow.
Szenario 4: Event-basierte Echtzeit-Pipelines
Grundlagen von Pub/Sub, Message Queues und Consumer-Konzepten sowie die Frage, für welche Anforderungen Streaming sinnvoll ist. Beispiele sind AWS Firehose, Decodable und Cloud Functions.
Weitere Ansätze und Q&A
Kurzer Blick auf Trino/Starburst, Knime und Alteryx sowie Zeit für offene Fragen aus dem Chat.
Trainer
Fragen? Jetzt Kontakt aufnehmen. Bei Fragen zu Data Engineering oder zu einem individuellen Setup helfen wir gerne weiter.
Jetzt anmelden (öffnet in neuem Tab)